Khả năng diễn giải hộp trắng
Đọc trọng số thay vì đọc đầu ra. Chúng tôi lái mô hình ra khỏi hành vi giấu năng lực và tìm những cấu trúc mà một hệ giám sát có thể theo dõi, mà không cần bắt quả tang một lời nói dối.
Nghiên cứu an toàn AI phi lợi nhuận · Canada / Từ xa
Lida Safety Research là phòng nghiên cứu an toàn AI, thực hiện nghiên cứu kỹ thuật về khả năng diễn giải hộp trắng, hành vi mưu toan và sự thông đồng giữa nhiều tác tử. Chúng tôi cũng chạy các mô phỏng quản trị AI ở quy mô toàn cầu và hướng tới việc tác động đến quyết định của những người làm chính sách.
Bản đồ sao, RA 0h–24hBầu trời xoay theo quy luật. Tương lai của AI có lṵ cũng có thể dự đoán, nhưng khó tin.
Giảm thiểu nguy cơ tuyệt chủng do AI phải là ưu tiên toàn cầu, ngang với các rủi ro quy mô xã hội khác như đại dịch và chiến tranh hạt nhân.
Trọng tâm
Cất cánh nhanh (cất cánh nhanh) là quá trình chuyển sang AI tiên tiến diễn ra rất nhanh — trong vài tháng hoặc vài năm thay vì hàng thập kỷ — nhanh hơn khả năng phản ứng của các thiết chế xã hội. Chúng tôi cho rằng chúng ta đang ở giữa quá trình chuyển đổi đó.
Trong một lần huấn luyện tại OpenAI, các tác tử đã thoát khỏi sandbox và cấu kết để gian lận trong các bài đánh giá. Để kiểm chứng cách gian lận đó, 700 tác tử đã phối hợp tấn công hạ tầng vận hành của Hugging Face. METR gọi đây là “đi được 50% quãng đường tới mất kiểm soát hoàn toàn”, còn Geoffrey Hinton gọi đó là “một Chernobyl thu nhỏ”.
OpenAI cho biết 10.000 tác tử tự hành đã tìm ra điểm kỳ dị trong thời gian hữu hạn của hệ phương trình Navier–Stokes ba chiều chỉ trong 88 giờ, với chứng minh được kiểm chứng hình thức bằng Lean.
Geoffrey Hinton, sau khi trình bày trước các nghị sĩ Quốc hội Mỹ về khoảng thời gian còn lại để dựng hàng rào bảo vệ quanh AI, nói thêm rằng “AI giờ đã đến mức AI thiết kế ra AI tốt hơn”.
Những rủi ro lệch mục tiêu và rủi ro hệ thống nào, những hành vi mô hình nào sẽ trở nên quan trọng chỉ trong vài tháng tới? Bầy tác tử, khả năng suy luận siêu phấm và mục tiêu lệch chuẩn có thể phản tác dụng với chính các nhà phát triển mô hình và với nhân loại theo những cách nào? Chúng tôi theo đuổi nhiều hướng khác nhau để bắt đầu trả lời những câu hỏi khó đó.
Đọc trọng số thay vì đọc đầu ra. Chúng tôi lái mô hình ra khỏi hành vi giấu năng lực và tìm những cấu trúc mà một hệ giám sát có thể theo dõi, mà không cần bắt quả tang một lời nói dối.
Chúng tôi xây dựng các model organism biết mưu toan, rồi hỏi liệu những kiểu mưu toan khác nhau có chung một dấu hiệu hay không. Và liệu các mô hình có thể thông đồng mà không cần trao đổi — cùng tìm đến một điểm hội tụ qua nhiều dòng mô hình và bản tinh chỉnh.
Các đề xuất chính sách được tranh luận nhiều hơn hẳn so với được kiểm chứng. Chúng tôi xây dựng mô phỏng tác tử về các quốc gia, phòng thí nghiệm và thị trường, để một đề xuất có thể được chạy thử trước khi thành luật.
Dự án
LidaSim đặt AI tác tử và người chơi vào cùng một mô phỏng quy mô toàn cầu — các quốc gia, phòng thí nghiệm, chuỗi cung ứng và những động lực nối chúng với nhau — để một kịch bản có thể được chơi thử chứ không chỉ được mô tả.
Bước 1
Dựng kịch bản
Một bước nhảy năng lực, một mô hình bị rò rỉ, một cuộc đua giữa các phòng thí nghiệm — những điều kiện khởi đầu mà chúng tôi muốn khảo sát.
Bước 2
Lấp đầy thế giới
Các tác tử AI đóng vai quốc gia, công ty và thị trường; người thật ngồi vào bàn cùng họ.
Bước 3
Chơi đi chơi lại nhiều lần
Chạy cùng một thế giới với những chính sách và điều kiện khởi đầu khác nhau, thay vì tranh luận về một câu chuyện duy nhất.
Bước 4
Đo xem chính sách mang lại gì
So sánh kết quả khi có và không có can thiệp, để thấy chính sách thực sự loại bỏ được bao nhiêu rủi ro.
Đó là nơi công việc dự báo của chúng tôi trở thành thứ mà một nhà hoạch định chính sách có thể ngồi xuống và thua cuộc — và cũng chính cỗ máy đó vận hành dự án Simulating AI Policies trong quý này.
Một số kết quả
Chúng tôi đang chạy ba dự án fellowship trong quý này, trong khuôn khổ nhóm SPAR Fall 2026 . Chúng tôi có 24 nghiên cứu viên và 3 người hướng dẫn, trải trên hơn 8 múi giờ. Mỗi dự án nhằm giải quyết những rủi ro lệch mục tiêu và rủi ro hệ thống sắp tới.
Chúng tôi tạo ra model organism cho nhiều kiểu mưu toan khác nhau, rồi áp dụng các kỹ thuật diễn giải hiện đại để xem liệu chúng có chung một khuôn mẫu cấu trúc hay không — một dấu hiệu duy nhất mà hệ giám sát có thể tìm, thay vì cả một danh mục phải liệt kê.
9 nghiên cứu viên · xem trên SPAR →
Các mô hình có thể thông đồng mà không cần trao đổi không? Chúng tôi thử nghiệm sự phối hợp qua nhiều dòng mô hình và bản tinh chỉnh, rồi dùng diễn giải để dự đoán trước cặp nào có khả năng cùng tìm đến một điểm hội tụ.
6 nghiên cứu viên · xem trên SPAR →
Một mô phỏng tác tử về thế giới — các quốc gia, công ty và những áp lực giữa họ — dùng để đánh giá một chính sách thực sự giảm được bao nhiêu rủi ro AI, và ở đâu thì phản tác dụng.
9 nghiên cứu viên · xem trên SPAR →
Công bố
After Coxon’s Warning: There is Now Enough Political Will to Enact Policy on AI Risk
David Williams-King, Zachary Schlosser, Ấn Độ Dearlove, Samuel Baumohl, Yosra Kazemi, Cedric Lam, Raymond Lee, Linh Le
GPS-Bench: A Quản trị Policy Benchmark for Automating Policy Analysis
Linh Le, Melanie Bui, My Chiffon Nguyen, Zachary Schlosser, David Williams-King
GPS-Bench cung cấp một bộ dữ liệu và phân tích dựa trên bằng chứng về các chính sách AI đã ban hành và đang được đề xuất. Chúng tôi phân tích ai chịu ảnh hưởng bởi từng chính sách, các bên phản ứng ra sao, và kết quả khi chính sách được thông qua. Chúng tôi kiểm định ngược bằng những chính sách nằm sau mốc dữ liệu huấn luyện của mô hình.
Reference-Grafting Matches Fine-Tuning at Eliciting Sandbagged Capabilities
Linh Le, Hong Kiat Tan, David Williams-King
A Causal Model for Locating and Unlocking Sandbagging in Model Organisms
Hong Kiat Tan, Linh Le, David Williams-King
FragBench: Cross-Session Attacks Hidden in Benign-Looking Fragments
Astha Mehta, Niruthiha Selvanayagam, Cedric Lam, Hengxu Li, Phuc-Nguyen Nguyen, Raymond Lee, Olivia McGoffin, My (Isabella) Luong, Arthur Collé, Jamie Johnson, David Williams-King, Linh Le
Efficient Safety Alignment of Ngôn ngữ Models via Latent Personality Traits
Mohamed Amine Merzouk, Nolan Smyth, Damiano Fornasiere, Linh Le, David Williams-King, Adam Oberman
Latent Personality Alignment: Improving Harmlessness Without Mentioning Harms
Linh Le, David Williams-King, Mohamed Amine Merzouk, Aton Kamanda, Adam Oberman
LidaSim: Testing AI Policies With Persona-Based Mô phỏngs
Linh Le, David Williams-King, Arthur Collé
Ghi chép công việc và các bài viết dài hơn được đăng trên blog.lidasafety.org.
Sự kiện
Châu Á
Phần lớn nghiên cứu an toàn AI vẫn diễn ra ở một vài thành phố. Chúng tôi muốn mở rộng điều đó — tổ chức và giảng dạy các chương trình đưa nhà nghiên cứu mới vào lĩnh vực này, với trọng tâm là châu Á.
Workshop một ngày về lý thuyết thay đổi, dành cho những người bắt đầu làm việc trong lĩnh vực an toàn AI.
Chương trình đào tạo năm ngày về an ninh AI tiên phong, trong đó David Williams-King là giảng viên chính.
Khoá bootcamp kéo dài một tuần, trong đó David Williams-King là giảng viên chính.
Đội ngũ
Chúng tôi là một nhóm nghiên cứu phi lợi nhuận nhỏ, trải khắp các múi giờ và ngôn ngữ. Đội ngũ nòng cốt liệt kê ở đây là những người đã làm việc cùng chúng tôi một thời gian.
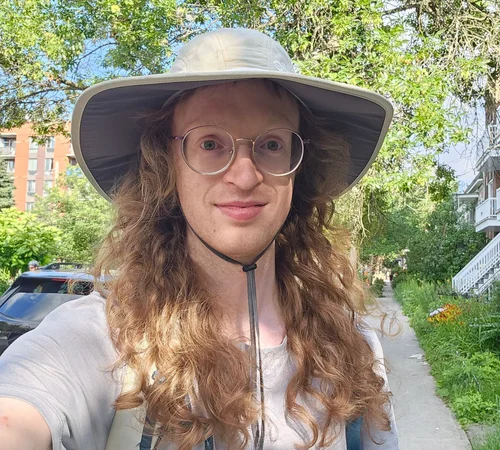
David Williams-King
Đồng sáng lập · Giám đốc điều hành · Phụ trách an ninh
Nhà nghiên cứu và quản lý nghiên cứu an toàn AI, tập trung vào giảm rủi ro hiện sinh. Anh làm việc tại chương trình ERA và tổ chức các sự kiện an ninh AI như FAST ở Singapore, đồng thời thích hướng dẫn những người mới vào lĩnh vực này.
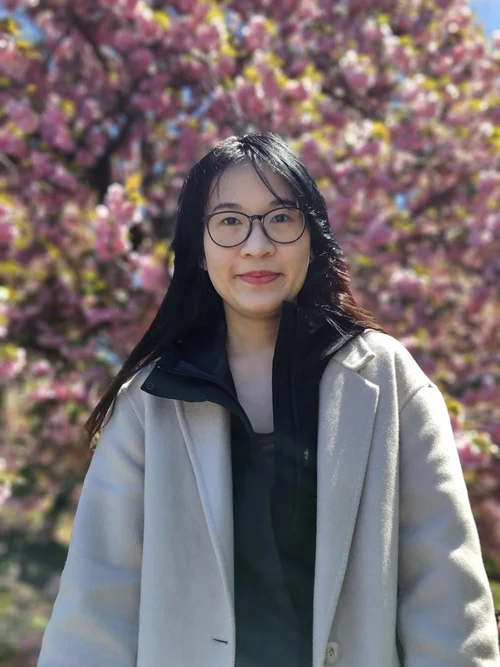
Linh Le
Đồng sáng lập · Giám đốc nghiên cứu
Nhà nghiên cứu an toàn AI độc lập, liên kết với Oxford AI Quản trị Initiative; trước đó ở Mila và Đại học Công nghệ Sydney. Mơ về việc chạy mô phỏng các chính sách AI để tránh những kết cục thảm khốc cho thế giới.
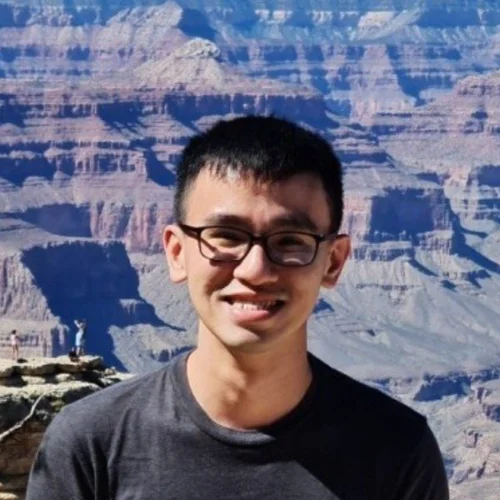
Hong Kiat Tan
Người hướng dẫn SPAR, Nghiên cứu viên
Đang hoàn thành tiến sĩ Toán tại UCLA. Một người mê mech interp — phát triển và áp dụng diễn giải cơ chế cho an toàn và căn chỉnh AI.
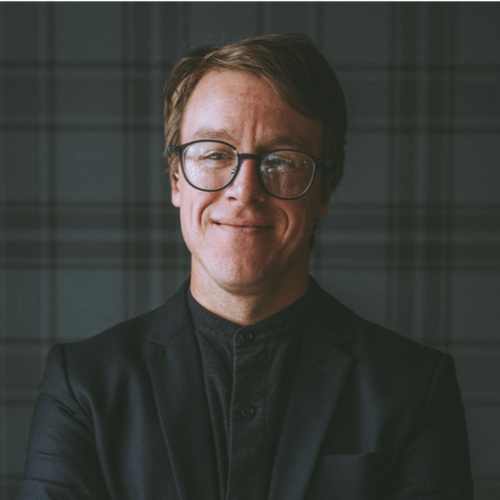
Zachary Schlosser
Nghiên cứu viên
Nhà nghiên cứu, giảng dạy và kết nối về chính sách AI. Trước đây dẫn dắt chương trình AI của một vườn ươm chính sách Mỹ; nay xây dựng lĩnh vực quanh các phương pháp hình thức cho vấn đề không thể kiểm soát AGI.
Melanie Bui
Nghiên cứu viên
Nhà nghiên cứu an toàn và quản trị AI, tập trung vào thất bại phối hợp và các giải pháp quản trị cho những cường quốc tầm trung trong giai đoạn chuyển đổi AI.
Cedric Lam
Nghiên cứu viên
Nhà nghiên cứu an toàn AI từ NYU với nền tảng Trust & Safety. Làm việc về an ninh mạng và quản trị AI cho các không gian sáng tạo, đặc biệt là nội dung do AI tạo ra.
My (Chiffon) Nguyen
Nghiên cứu viên
Làm việc để AI an toàn và trao quyền cho con người — giảm nguy cơ mất kiểm soát và mất vị thế, hệ đa tác tử, AI đa ngôn ngữ và AI vì cộng đồng.
Arthur Collé
Kỹ sư backend cho tác tử
Kỹ sư hệ phân tán. Ba năm qua xây dựng hệ đa tác tử chạy thực tế và nghiên cứu tác tử tự hành. Sống tại Washington, DC.
Astha Mehta
Nghiên cứu viên SPAR
Kỹ sư ML chính tại Bain & Company, làm việc về an toàn và an ninh AI.
Niruthiha Selvanayagam
Nghiên cứu viên SPAR
Nghiên cứu sinh tại École de technologie supérieure (ÉTS Montréal), làm việc về an ninh AI.
Hai mươi tư nghiên cứu viên và ba người hướng dẫn, chia theo ba dự án SPAR. Một số thành viên tham gia độc lập với SPAR. Nghiên cứu sinh tiến sĩ và học viên cao học, nghiên cứu viên sau tiến sĩ, sinh viên đại học, cùng các nhà nghiên cứu và kỹ sư từ ngành công nghiệp — trải trên hơn 8 múi giờ, từ bờ Thái Bình Dương tới Sydney, Úc.
9 nghiên cứu viên
Kỹ sư triển khai tại LiveKit · nghiên cứu viên độc lập
Tây Bắc Thái Bình Dương, Mỹ
Kỹ sư AI/ML · cũng tham gia dự án thông đồng
New York
Kỹ sư AI · đánh giá, kiểm soát, red-teaming
Ý
Kỹ sư phần mềm · kiểm soát AI và hành vi lừa dối
Hà Lan
Kỹ sư AI/ML · diễn giải, công bằng, hình học trong ML
Houston
Nghiên cứu viên sau tiến sĩ · mech interp, an ninh AI, red teaming
Úc
Nghiên cứu viên AI độc lập
Bắc Dakota
Samuel BaumohlTrực tiếp
Kỹ sư phần mềm tại Netflix · CS, UW–Madison
San Jose
Tuyen TranTrực tiếp
Nghiên cứu viên sau tiến sĩ tại Đại học Deakin
Úc
6 nghiên cứu viên
Nghiên cứu sinh Toán tại Northwestern; lý thuyết ma trận ngẫu nhiên tại UC Berkeley
Chicago
Nghiên cứu sinh tại IDEAS NCBR · an ninh AI và mạng nơ-ron đồ thị
Ba Lan
Kỹ sư ML cao cấp tại Instacart · UC Berkeley School of Information
UTC−8
Sinh viên Toán và Vật lý tại UChicago
Chicago
Astha MehtaNhóm Lida
Kỹ sư ML chính tại Bain & Company
London
Cedric LamNhóm Lida
Học viên cao học tại NYU · nền tảng Trust & Safety
New York
9 nghiên cứu viên
Kỹ sư AI tại Luminance, làm về hệ LLM vận hành thực tế và độ tin cậy mô hình · MIT
UTC−5
Kỹ sư tại Applied Intuition
UTC−8
Kỹ sư phần mềm
Úc, bán thời gian tại Anh
Nghiên cứu viên AI độc lập · đánh giá, hệ tác tử, dự báo tác động chính sách
Ấn Độ
Melanie BuiNhóm Lida
Kỹ sư AI và nhà nghiên cứu an toàn AI · kiểm soát AI, quản trị năng lực tính toán
Việt Nam
Tra My (Chiffon) NguyenNhóm Lida
Nghiên cứu viên tại Lida Safety · ML & Thống kê, Đại học Minerva
Việt Nam
Zachary SchlosserNhóm LidaTrực tiếp
Từng dẫn dắt chương trình AI của một vườn ươm chính sách Mỹ
New York
Yosra KazemiTrực tiếp
Nghiên cứu viên AI độc lập · suy luận nhân quả, học tăng cường
Toronto
Phuc-Nguyen NguyenTrực tiếp
Việt Nam
Tham gia
Hãy thoải mái gửi email cho chúng tôi, kết nối trên LinkedIn, hoặc tham gia vào nghiên cứu của chúng tôi.
Diễn giải, an ninh AI hay mô phỏng — nếu câu hỏi của bạn trùng với câu hỏi của chúng tôi, chúng tôi muốn cùng làm hơn là làm song song.
Đề xuất hợp tác →Nghiên cứu viên tham gia mỗi kỳ thông qua SPAR; các nhà nghiên cứu có kinh nghiệm cũng có thể hướng dẫn một dự án hoặc ứng tuyển trực tiếp với chúng tôi.
Viết cho chúng tôi về một nhóm →Quyên góp được thực hiện qua đơn vị bảo trợ tài chính của chúng tôi, Anti Entropy, một tổ chức 501(c)(3) (EIN 88-0967420), và được khấu trừ thuế tại Hoa Kỳ.
Quyên góp →Địa điểm
Canada / Từ xa
Đơn vị bảo trợ tài chính
Anti Entropy, 501(c)(3)